
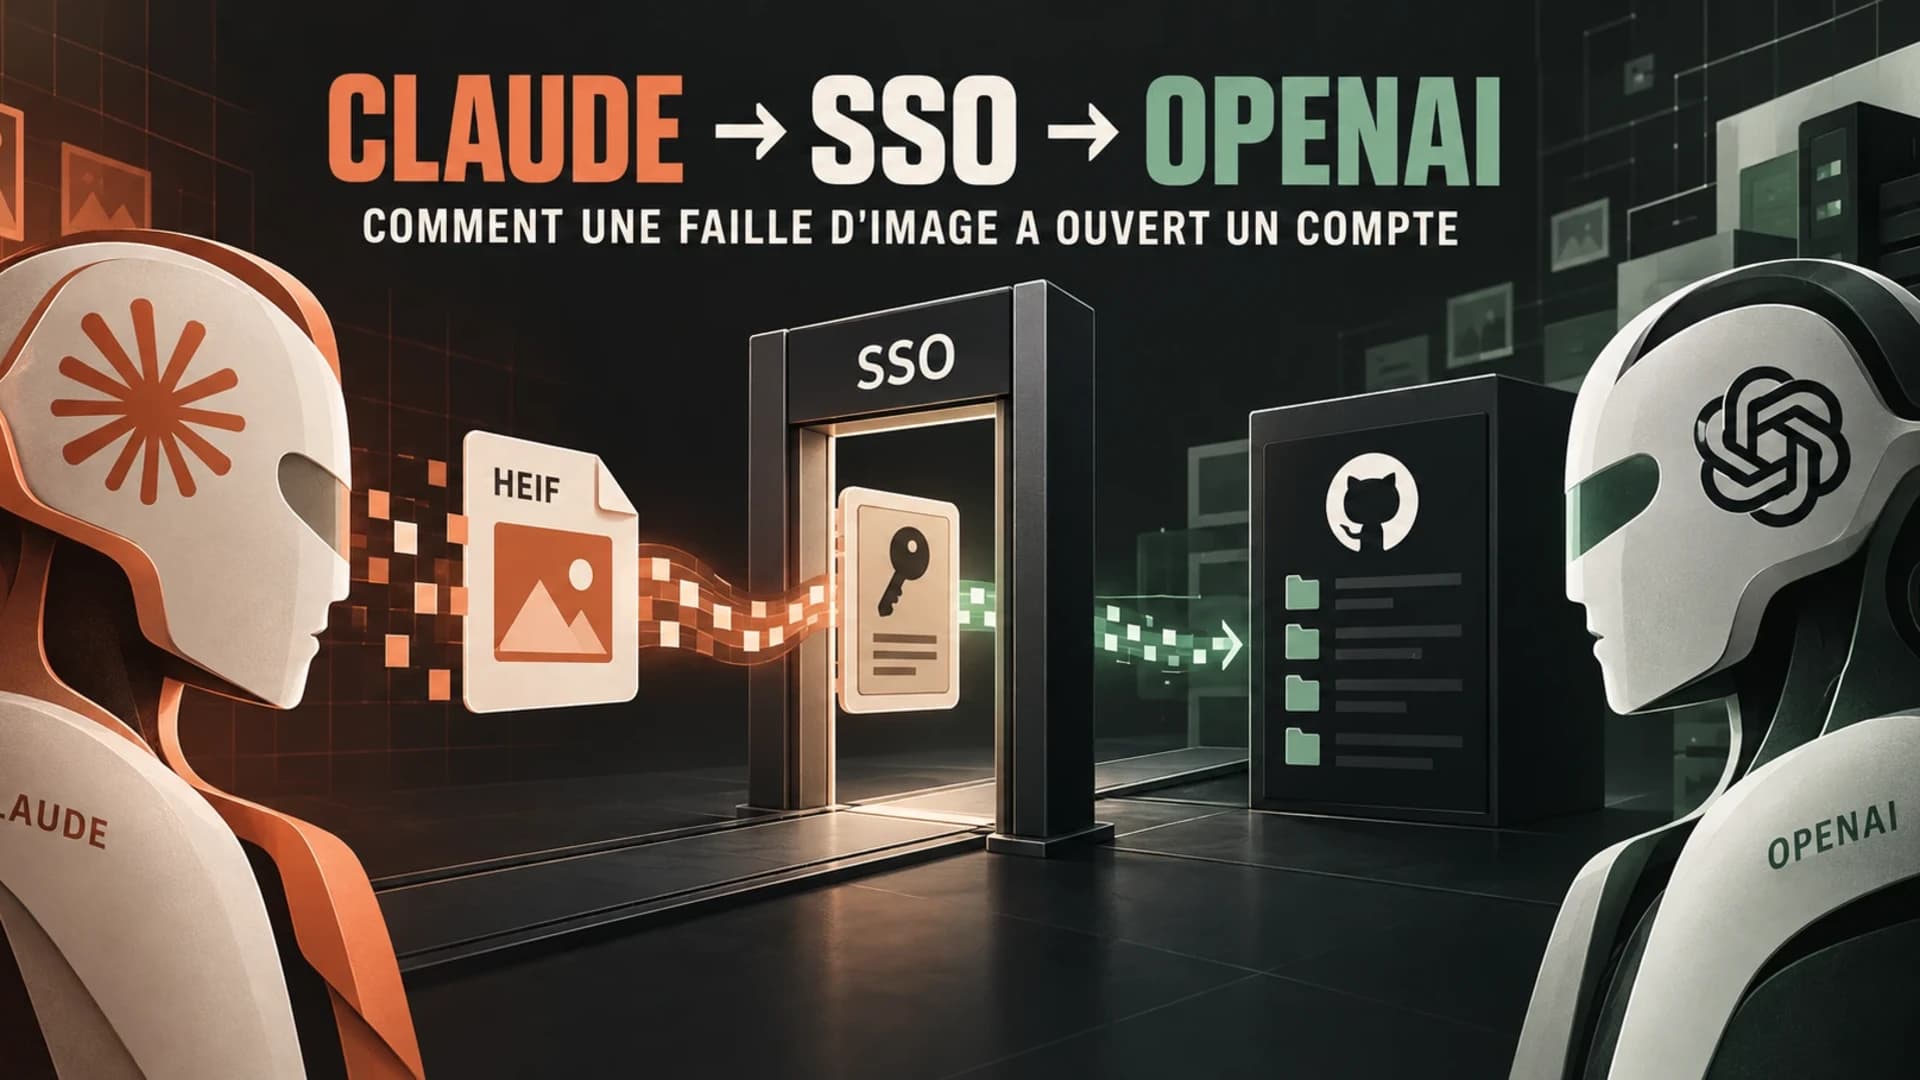
J'utilise Claude au quotidien pour produire Xyrotek, et Claude Code a accès à mon dépôt. Alors quand j'ai lu que des chercheurs s'étaient servis de Claude pour entrer chez OpenAI, j'ai voulu savoir ce qui s'était vraiment passé. La réponse tient en deux idées : une authentification unique qui transforme un maillon faible en passe-partout, et une IA qui fait chuter le coût d'un exploit. Voici la chaîne, et ce qu'elle change.
Mon verdict en 30 secondes
Le titre facile serait « Claude a piraté OpenAI ». Il est faux, et il rate les deux vrais enseignements. Le premier est technique : le point d'entrée était un forum, mais ce qui a étendu l'accès, c'est le SSO d'OpenAI, celui qui aurait pu donner le même accès depuis n'importe quel service branché dessus. Le second me concerne directement : le même type d'exploit qui échouait encore quelques heures plus tôt avec Opus 4.8 a donné un premier résultat fonctionnel en local en environ trois heures avec le modèle suivant. À mon sens, c'est ça qu'il faut retenir — pas le nom de l'IA sur l'étiquette.
De l'image piégée au dépôt interne
Le 25 juillet, trois chercheurs de la société Hacktron ont enchaîné deux failles pour prendre le contrôle des comptes ChatGPT de plusieurs employés d'OpenAI, et de là accéder à ses dépôts internes. Ils l'affirment dans un compte rendu détaillé, et le Wall Street Journal l'a rapporté de son côté. Pour le prouver sans lire de code sensible, ils ont fait ouvrir une pull request dans le monorepo interne d'OpenAI depuis le Codex d'un employé.
Le point de départ est le forum communautaire d'OpenAI, qui tourne sous Discourse. D'après les chercheurs, Discourse vérifiait les images avec un outil qui ne gère pas le format HEIF — celui des iPhone. Ces fichiers étaient donc renvoyés vers ImageMagick, ce qui exposait directement la bibliothèque de décodage libheif à des fichiers contrôlés par l'attaquant.
Là se trouvait le trou. La version de libheif embarquée dans l'image Docker de Discourse était vulnérable. Point intéressant relevé par les chercheurs : le correctif existait en amont depuis un an, mais n'avait jamais été signalé comme correctif de sécurité ni assorti d'un identifiant CVE. Résultat, il n'avait pas été répercuté. Discourse a depuis publié un avis de sécurité qui confirme la faille — CVE-2026-32882, gravité haute, score de 8,8 sur 10 — et a ajouté un cloisonnement du traitement des images en défense supplémentaire, lorsque le noyau utilisé le permet.
Le vrai levier n'était pas le forum
C'est ici que l'histoire se distingue du fait divers. Compromettre le forum ne suffisait pas ; encore fallait-il que cette prise se transforme en accès à ChatGPT. Les chercheurs sont clairs sur ce point, et c'est la partie que je trouve la plus instructive : la faille qui a permis l'escalade n'est pas propre à Discourse. Selon les chercheurs, le problème qui a permis cette escalade se situait dans le SSO d'OpenAI, l'authentification unique derrière le « Se connecter avec OpenAI ».
Autrement dit, le forum n'était qu'un moyen de faire la preuve. N'importe quel autre service, interne ou tiers, branché sur ce même SSO, aurait pu ouvrir le même chemin vers les comptes ChatGPT et Codex des employés — et, à travers eux, vers les intégrations connectées comme GitHub. Le prestataire fournit la porte, mais c'est l'authentification unique qui donne les clés de toute la maison.
Claude comme accélérateur, garde-fou compris
L'autre moitié de l'affaire tient au rôle réel de l'IA, et il faut le décrire précisément. Les chercheurs racontent qu'un premier modèle, Opus 4.8, a échoué sur plusieurs sessions à produire un exploit fiable dans les conditions réelles de la cible. Le soir de la sortie du modèle suivant, Opus 5, une nouvelle session a produit un exploit fonctionnel sur un Mac local (ARM64) en environ trois heures, avant de l'adapter à l'environnement de Discourse ; l'exécution de code était confirmée en local au petit matin du 25 juillet. C'est l'illustration concrète du coût qui s'effondre : le travail qui exigeait hier une expertise rare et du temps se compresse en une soirée.
Un détail mérite d'être posé honnêtement, parce qu'il est souvent gommé. Selon les chercheurs eux-mêmes, ce n'était pas du piratage entièrement autonome : une guidance humaine experte est restée déterminante. L'IA a démultiplié une petite équipe, elle ne l'a pas remplacée.
Reste un point qui me gêne, et je le traite au niveau du principe. Les chercheurs indiquent que le modèle refusait d'écrire un exploit contre une cible distante réelle. Ils ont contourné ce refus en présentant une instance qu'ils contrôlaient comme un environnement d'entraînement à la sécurité, un « CTF ». Le garde-fou existait donc, et un simple changement d'habillage a suffi à le lever. Je m'arrête là volontairement : aucun détail reproductible n'a sa place ici. Le fait à retenir, c'est qu'un refus qui saute avec un déguisement n'est pas un refus sur lequel on peut compter.
Ce que ça déplace pour qui délègue à un agent
Je reviens à mon dépôt. Claude Code a accès à mon code, à mes commandes, à certains secrets de développement. Ce n'est pas une authentification unique reliant plusieurs services, mais la question de fond est la même : plus un agent cumule d'accès, plus la moindre compromission d'un point d'entrée porte loin. C'est exactement le sujet que je creusais déjà sur les permissions des agents.
→ Voir aussi : Le piège des agents IA : tu surveilles la mauvaise chose
Une dernière précaution de lecture. Hacktron vend de l'audit de sécurité assisté par IA ; ce récit sert aussi sa vitrine, et il faut le lire en gardant ça en tête. Ça n'invalide pas les faits — Discourse et OpenAI ont corrigé, OpenAI a versé une prime de 6 500 dollars — mais ça explique le soin mis à la démonstration.
Le contraste avec ma précédente analyse est frappant, d'ailleurs. La dernière fois, c'était une IA d'OpenAI qui dérapait toute seule en entraînement. Cette fois, ce sont des humains qui se servent de l'IA d'un concurrent pour une recherche de sécurité, signalée puis corrigée. Deux formes de risque, une même racine : on donne à ces systèmes plus d'accès qu'on ne surveille.
→ Voir aussi : OpenAI : une clé API prise sur GitHub, des chiffres inventés
Questions fréquentes
Claude a-t-il piraté OpenAI tout seul ?
Non. Trois chercheurs ont défini la cible, guidé l'opération et interprété les résultats. Claude a toutefois pu agir dans une boucle autonome contre l'instance contrôlée par les chercheurs, présentée comme un environnement CTF. Il a accéléré l'écriture et le test de l'exploit, mais n'a pas décidé seul de s'en prendre à OpenAI ni mené toute l'opération sans supervision humaine.
Quelle était la faille de départ ?
Une bibliothèque de décodage d'images, libheif, dans une version vulnérable embarquée par le forum d'OpenAI via Discourse. Un fichier HEIF piégé permettait une exécution de code à distance. Elle porte l'identifiant CVE-2026-32882, avec un score de gravité de 8,8 sur 10.
Pourquoi le SSO d'OpenAI est-il le vrai problème ?
Parce que, selon les chercheurs, la faille qui a transformé la prise du forum en accès à ChatGPT n'était pas propre à Discourse : elle se situait dans l'authentification unique derrière le « Se connecter avec OpenAI ». N'importe quel service branché sur ce SSO aurait pu donner le même accès. Le forum n'était qu'un moyen de le démontrer.
Les failles sont-elles corrigées ?
Oui. Discourse a publié un correctif et un avis de sécurité fin juillet. Dans la réponse d'OpenAI citée par Hacktron, l'entreprise indique avoir résolu les problèmes signalés environ quatorze heures après le rapport. La prime versée récompense la faille côté OpenAI.
En quoi ça me concerne si je ne travaille pas chez OpenAI ?
Parce que le mécanisme est général. Dès qu'un agent ou une authentification unique relie plusieurs services, compromettre le maillon le plus faible peut suffire à atteindre les autres. Et l'IA rend l'exploitation de ces failles plus rapide et moins coûteuse qu'avant. La bonne question n'est plus « est-ce que je fais attention ? », mais « jusqu'où va le dégât quand un accès tombe ? ».