
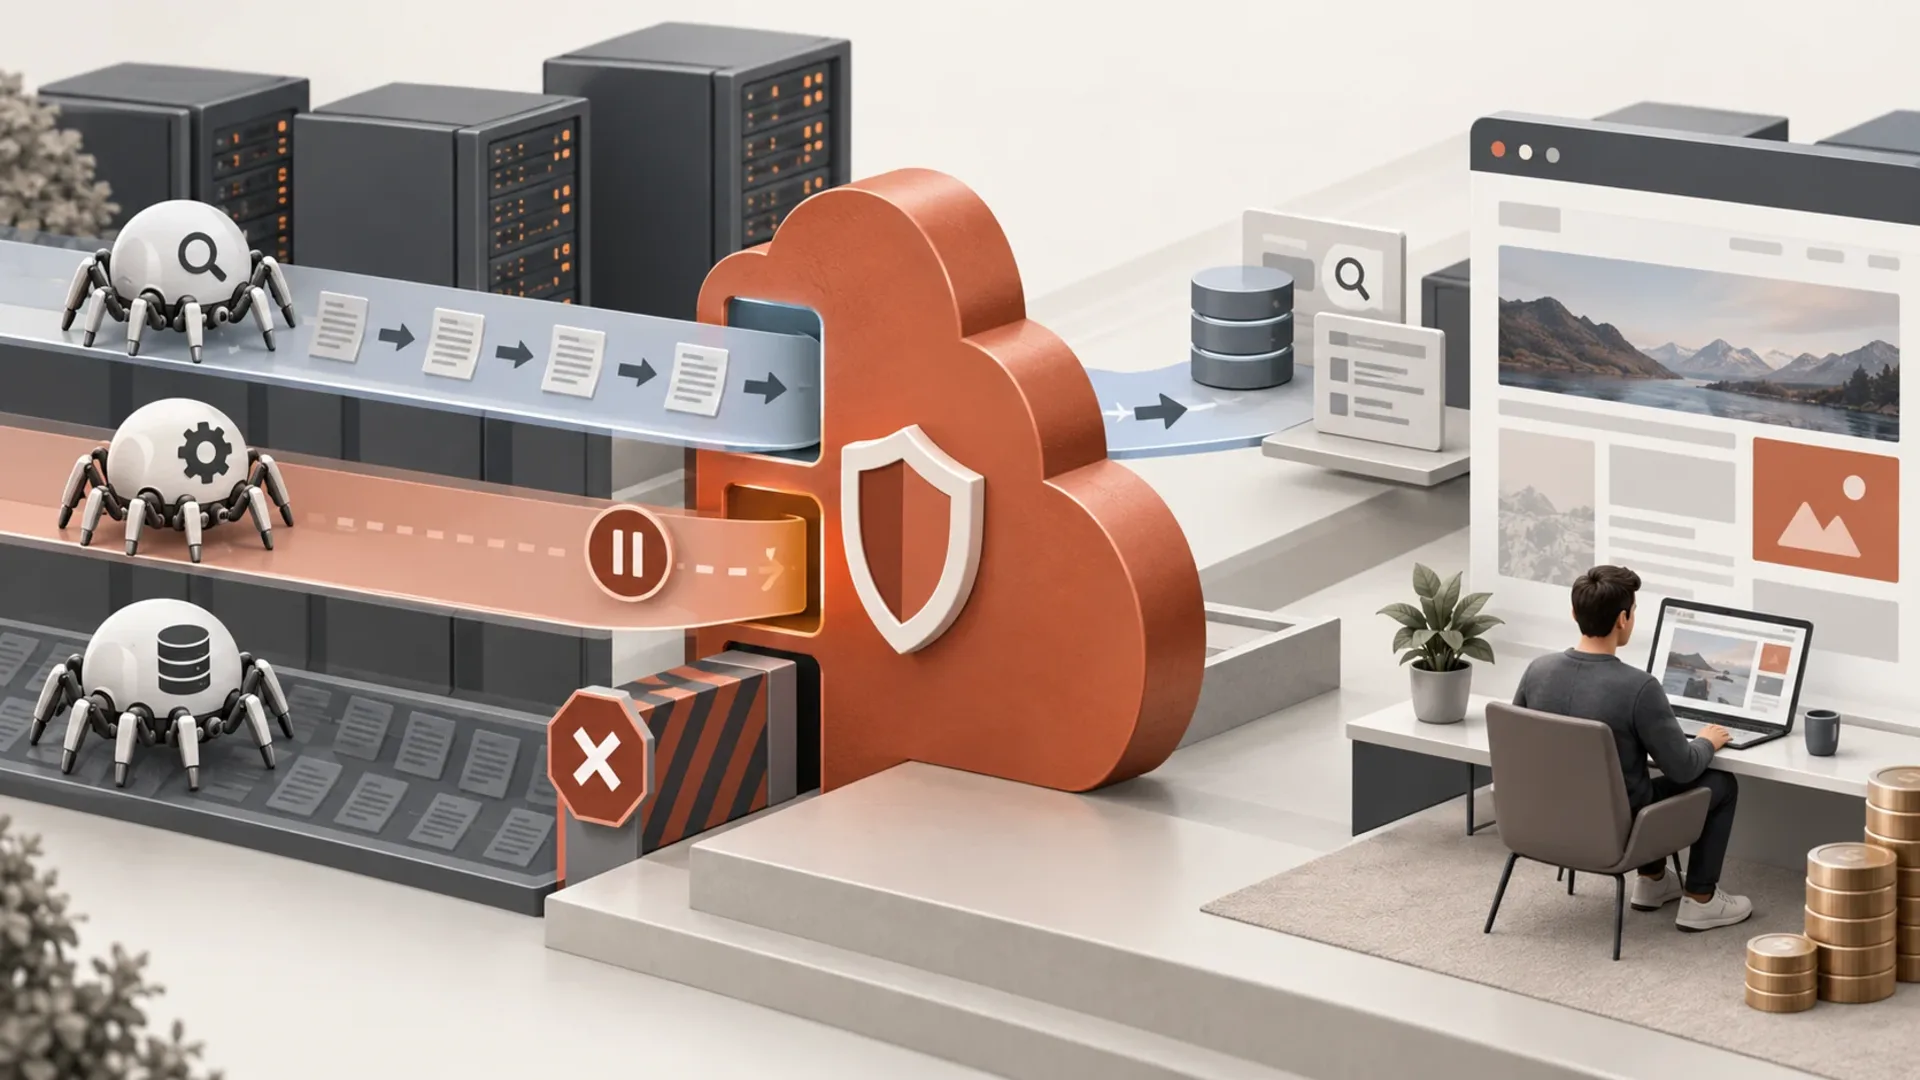
Tu publies un article. Dans l'heure qui suit, plusieurs automates viennent le lire, et ils ne cherchent pas la même chose. L'un l'indexe pour qu'il ressorte un jour dans un moteur de recherche. Un autre récupère son texte pour entraîner un modèle. Un troisième le consulte en direct, parce qu'un utilisateur vient de poser une question à un assistant et attend la réponse.
Jusqu'ici, ces trois visiteurs étaient traités comme un seul bloc : robot IA, oui ou non. Cloudflare propose désormais de distinguer ces usages, et applique à partir du 15 septembre 2026 de nouveaux réglages par défaut.
Ce que Cloudflare change le 15 septembre
Deux choses, qui ne touchent pas les mêmes personnes.
La première concerne les nouveaux domaines. Cloudflare indique que les domaines qui arrivent sur la plateforme à partir du 15 septembre reçoivent des réglages par défaut modifiés : sur les pages qui affichent de la publicité, les robots classés Training et Agent sont bloqués, tandis que ceux classés Search restent autorisés.
La seconde est plus discrète et touche des sites déjà en place. À la même date, les robots qui cumulent plusieurs comportements ne sont plus jugés sur un seul, mais sur l'ensemble de ce qu'ils font — et la règle la plus restrictive s'applique. Concrètement, un site qui a choisi de bloquer le Training bloquera aussi les robots qui font à la fois de la recherche et de l'entraînement.
Cloudflare précise que chaque propriétaire de site pouvait refuser ces réglages par défaut dans ses paramètres de sécurité, jusqu'au 14 septembre inclus. Ce n'est donc pas une décision imposée sans recours.
Search, Agent, Training : trois comportements, trois enjeux
Le cœur du changement est une question de vocabulaire, et elle mérite qu'on s'y arrête.
Search désigne les robots qui parcourent un site pour l'indexer et pouvoir répondre plus tard à des questions à son sujet. C'est la catégorie qui, historiquement, renvoie des visiteurs. Cloudflare écrit qu'un propriétaire de site est en droit d'en attendre du trafic de référence ou une compensation équivalente.
Agent désigne les automates qui agissent en temps réel pour le compte d'une personne. Un assistant qui va chercher une page pour répondre à une question posée à l'instant, ou un agent qui pilote un navigateur, entrent dans cette catégorie. Le point important : il y a généralement un humain qui attend au bout.
Training désigne les robots qui collectent du contenu pour entraîner ou affiner un modèle. Le contenu est absorbé dans le modèle, et le site d'origine n'apparaît plus nulle part.
Cloudflare suit en réalité onze comportements : Search, Agent, Training, Transact, Data Collection, Security Testing, SEO, Ads Verification, Social / Link Preview, Feed Fetching et Monitoring & Operations. Les trois premiers sont les seuls proposés comme réglages configurables à tous les clients, y compris ceux de l'offre gratuite.
Ce que cela change pour les sites avec publicité
La logique avancée par Cloudflare est simple : une publicité signale que le propriétaire du site attend qu'un humain arrive sur la page et la voie. Sur ces pages, l'attention humaine est l'objectif, donc les automates qui la remplacent ou qui ne rendent rien sont écartés par défaut.
D'où le découpage retenu : Training et Agent bloqués sur les pages monétisées, Search laissé passer parce que c'est le comportement qui ramène des visiteurs.
Pour chaque catégorie, trois choix sont proposés dans l'interface : bloquer sur toutes les pages, bloquer uniquement sur les pages qui affichent des publicités, ou ne pas bloquer. Ce troisième réglage — le blocage limité aux pages publicitaires — est la nouveauté qui rend le dispositif utilisable par un éditeur qui ne veut pas tout fermer.
Un point d'analyse, qui n'est pas dans le texte de Cloudflare : bloquer les agents sur une page monétisée est un arbitrage, pas un gain automatique. Un agent qui lit ta page peut aussi te citer et t'amener un lecteur ensuite. Personne ne sait aujourd'hui quelle part de trafic ces agents envoient réellement, et la question reste ouverte.
Le cas des robots polyvalents
C'est la partie qui peut surprendre, et qui concerne les sites déjà hébergés derrière Cloudflare.
Certains robots font plusieurs choses avec le même agent. Cloudflare cite Googlebot, Applebot et BingBot comme exemples de robots susceptibles d'être classés dans plusieurs catégories. À partir du 15 septembre, ces robots sont évalués sur l'ensemble de leurs comportements, et c'est la règle la plus restrictive qui l'emporte.
Conséquence directe, écrite noir sur blanc par Cloudflare : ces robots polyvalents seront bloqués chez les clients ayant choisi de bloquer le Training — que ce soit via les nouvelles options ou via l'ancien réglage « Block AI bots ».
Si tu as activé ce blocage global il y a un an sans y repenser depuis, c'est exactement ta situation. Ça ne veut pas dire que Google perd automatiquement l'accès à ton site : ça dépend de la classification du robot concerné et du réglage que tu as choisi. Mais ça mérite une vérification avant de constater une baisse d'indexation.
Ce qu'il faut vérifier dans tes réglages
Quatre points, dans l'ordre.
Regarde d'abord si l'ancien réglage « Block AI bots » est actif sur ton domaine. C'est lui qui produit l'effet de bord décrit plus haut, et Cloudflare le désigne désormais comme un service hérité, aux côtés des nouvelles options. Il se trouve dans les paramètres de sécurité de ta zone, dans la configuration des robots IA.
Regarde ensuite les trois nouveaux réglages Search, Agent et Training, et vérifie qu'ils correspondent à ce que tu veux réellement — pas à ce que tu avais coché avant que la distinction existe.
Vérifie aussi si tes pages affichent des publicités, puisque c'est le critère qui déclenche le blocage par défaut. Une page monétisée et une page sans publicité ne seront pas traitées pareil.
Enfin, si tu utilises le fichier robots.txt géré par Cloudflare, sache qu'il inclut désormais un signal supplémentaire sur l'usage du contenu. Cloudflare teste une extension, use, avec trois valeurs : immediate pour interagir sans rien conserver, reference pour indexer et citer avec un lien, full pour résumer et reproduire. Les sites ayant activé ce robots.txt géré reçoivent use=reference.
Attention à la portée de cette dernière ligne : comme tout ce qui figure dans un robots.txt, il s'agit d'une préférence exprimée au robot, pas d'un blocage technique. Cloudflare indique que ces signaux reposent sur la coopération des robots : un opérateur qui les ignore ne peut pas être contraint par robots.txt. Pour un blocage technique, il faut utiliser les règles de protection de Cloudflare.
Ces signaux ne sont pas pour autant sans conséquence. Cloudflare indique qu'un robot qui en abuse peut perdre son statut « Verified » et ne plus être autorisé. Les robots qui reproduisent intégralement le contenu ne peuvent pas obtenir ce statut.
Ce que cette annonce ne signifie pas
Trois malentendus à écarter.
Ce n'est pas une règle qui s'applique à tous les sites du web. Elle concerne la politique de Cloudflare et les sites qui passent par son réseau. Un site hébergé ailleurs n'est pas concerné.
Ce n'est pas un blocage automatique de toutes les IA partout. Les nouveaux réglages par défaut visent les nouveaux domaines, sur les pages publicitaires, pour deux catégories sur trois — et chaque propriétaire peut les modifier.
Ce n'est enfin pas une promesse de résultat. Rien dans ces annonces ne garantit un meilleur référencement, plus de trafic ou plus de revenus. Cloudflare fournit un réglage, pas un effet.
Mon verdict
Le vrai apport n'est pas le blocage, c'est la distinction. Pendant trois ans, la seule question posée aux éditeurs était « robots IA : oui ou non », ce qui obligeait à choisir entre la visibilité et la protection de son contenu. Séparer l'indexation, la consultation en direct et l'entraînement rend enfin ce choix discutable.
Le point à retenir pour aujourd'hui est plus terre à terre : si ton site est derrière Cloudflare et que tu avais coché « bloquer les robots IA » sans y revenir, ton réglage ne veut plus tout à fait dire la même chose depuis le 15 septembre. Va le regarder.
Questions fréquentes
Mon site existant est-il concerné par les nouveaux réglages par défaut ?
Les nouveaux réglages par défaut s'appliquent aux domaines qui arrivent sur Cloudflare à partir du 15 septembre 2026. En revanche, le changement de traitement des robots polyvalents peut concerner un site existant : si tu as choisi de bloquer le Training, les robots qui combinent recherche et entraînement seront bloqués eux aussi.
Google va-t-il perdre l'accès à mon site ?
Pas automatiquement. Cloudflare cite Googlebot parmi les robots pouvant relever de plusieurs catégories, et indique que ces robots seront bloqués chez les clients ayant choisi de bloquer le Training. Le résultat dépend donc de la classification du robot et du réglage que tu as retenu.
Le fichier robots.txt suffit-il à bloquer les robots IA ?
Non. Un robots.txt exprime une préférence adressée aux automates, et ne constitue pas un blocage technique. C'est précisément la différence avec un réglage appliqué au niveau du réseau, qui refuse la requête.
Puis-je encore refuser ces nouveaux réglages ?
La fenêtre de refus préalable courait jusqu'au 14 septembre inclus. Les réglages Search, Agent et Training restent toutefois modifiables à tout moment dans les paramètres de sécurité de ta zone : ce sont des options, pas un verrou définitif.