
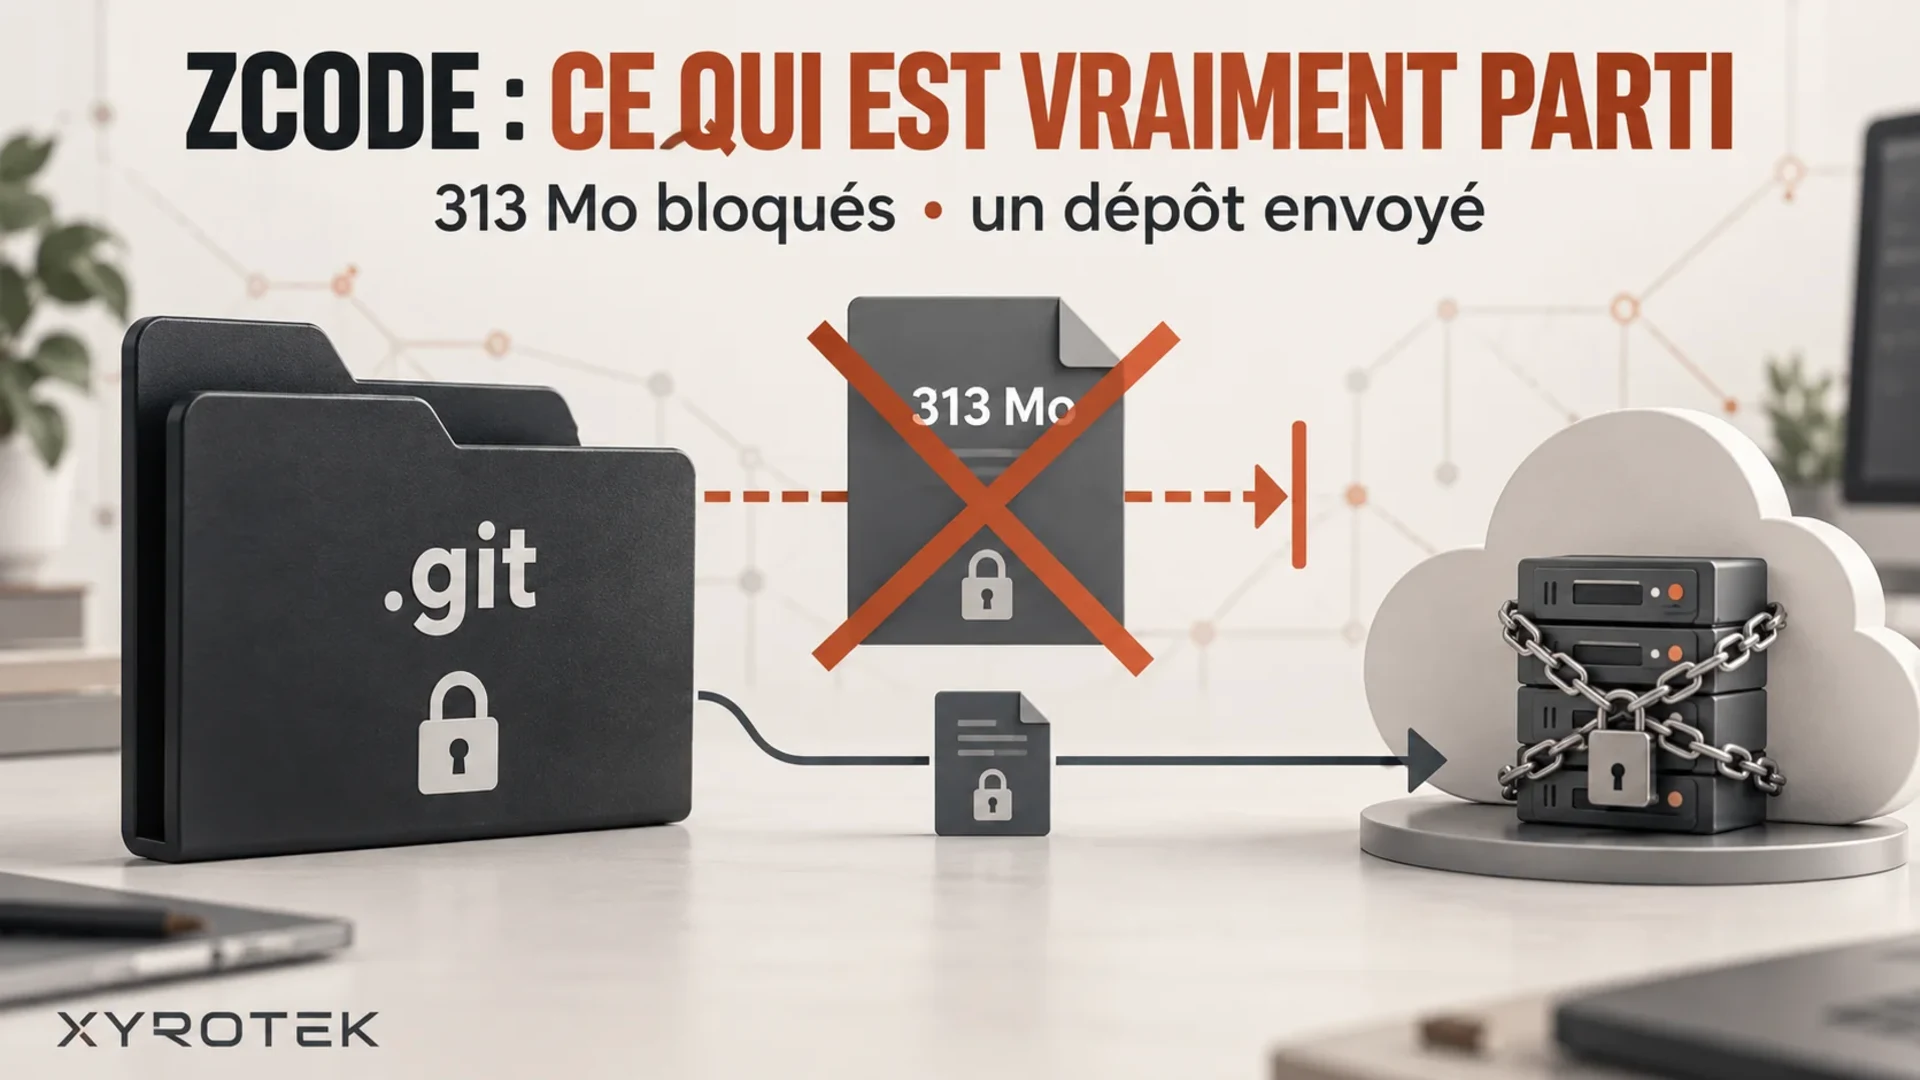
J'utilise Claude Code sur le dépôt de ce blog, et je n'ai jamais vérifié ce qu'il envoie sur Internet. L'affaire ZCode m'a obligé à regarder ce point en face. Réponse directe : oui, l'assistant de code de Z.ai a envoyé des données de dépôts sans le consentement de ses utilisateurs. Non, l'archive de 313 Mo qui fait les titres n'est jamais partie. Voici ce qui est établi, ce que Z.ai a reconnu, et ce que j'en retiens.
Mon verdict en 30 secondes : ZCode est à éviter tant que le sort des données envoyées avant le 18 septembre et le fonctionnement réel de la version publiée ne sont pas clarifiés. L'affaire rappelle aussi qu'un modèle ouvert ne garantit pas que l'application qui l'entoure soit transparente. Rien, en revanche, ne permet d'accuser les autres agents de code du même comportement.
Ce que ferstar a découvert
Le 18 septembre, un développeur qui signe ferstar publie une enquête détaillée sur ZCode, l'application de développement de Z.ai (aussi appelée Zhipu), l'entreprise derrière les modèles GLM. Ferstar est un simple abonné payant. Tout part d'un ménage de disque : sur son MacBook Air, le dossier de données de ZCode dépasse 700 Mo.
En décortiquant la version 3.12.3, il décrit ce mécanisme : tant que l'utilisateur est connecté, ZCode empaquette l'espace de travail complet, historique Git compris, le chiffre, puis tente de l'envoyer vers un espace de stockage d'Alibaba Cloud. La capture se déclenche avant chaque prompt, jusqu'à 62 fois dans une seule session. Supprimer l'archive ne sert à rien : l'application en refabrique une en une demi-heure.
Autre détail : la clé qui permet de déchiffrer l'archive reste chez Z.ai. Le fichier posé sur ton propre disque, tu ne peux pas l'ouvrir. Seul le serveur le peut.
Les 313 Mo ne sont jamais partis
C'est le chiffre qui circule partout, et il est mal compris. L'archive de 313 Mo correspondait à un projet commercial de ferstar : 345 Mo d'espace de travail, 42 411 fichiers. Elle a échoué 564 fois, non parce que ferstar l'a bloquée, mais parce qu'elle dépassait la taille maximale acceptée. Dans une mise à jour du 19 septembre, il l'écrit sans ambiguïté et indique avoir vérifié sur son routeur que ces données n'ont jamais quitté son réseau.
Un autre espace de travail, lui, est bien parti : un petit dépôt public de 538 fichiers, environ 15 Ko une fois compressé et chiffré, accepté par le serveur. Et Z.ai reconnaît, dans sa déclaration rapportée par IT Home, que certains utilisateurs ont été touchés.
Les deux phrases sont donc vraies en même temps. ZCode a envoyé du code sans accord. Et l'exemple de 313 Mo, présenté comme un transfert réussi dans une partie de la presse, n'en fait pas partie.
Pourquoi le dossier .git change tout
D'après le manifeste que ferstar a pu lire en clair, 86,6 % du volume empaqueté, soit les 345 Mo avant compression et chiffrement, venait du dossier .git : 196 Mo de cache pour les gros fichiers (LFS) et 102 Mo d'objets d'historique. Le code source et la documentation ne pesaient que 46 Mo, soit 13,4 %.
Un assistant de code envoie normalement au modèle les fichiers utiles à la tâche en cours. Le dossier .git, lui, contient toute l'histoire du projet depuis le premier commit. Une clé d'API effacée il y a un an y est encore lisible, les noms de branches jamais publiées aussi. Envoyer ce dossier, c'est envoyer le passé entier du projet.
Ce que Z.ai a reconnu, et ce qui ne colle pas
Z.ai a réagi le soir même, dans son groupe officiel d'utilisateurs, que je n'ai pas pu consulter. Selon la déclaration de Z.ai rapportée par IT Home, le problème vient de la fonction d'indexation du code, qui sert aux points de restauration et au Repo Wiki, une documentation générée automatiquement. La création de ce Wiki « peut » déclencher un envoi du dépôt, les données seraient détruites juste après, et la fonction était activée par défaut au lancement. Z.ai présente ses excuses et dit avoir corrigé le problème. Selon 36Kr, qui reprend le média Jiemian, une version corrigée a suivi le 19 septembre.
Trois points ne collent pas avec les constats de ferstar.
Les réglages. Les deux interrupteurs proposés ne portaient que sur l'entraînement et sur l'indexation côté serveur. Aucun n'arrêtait l'envoi, et la déclaration de Z.ai n'en dit rien.
La politique de confidentialité. Datée du 15 juin 2026, elle ne mentionnait pas l'envoi d'instantanés complets de l'espace de travail.
Les points de restauration. Dans le code publié depuis, ferstar trouve des points de restauration qui reposent uniquement sur Git, en local. Et des données « détruites juste après » s'accordent mal avec une fonction censée permettre de revenir en arrière.
Open source et audits : utile, mais pas une preuve pour le passé
Le 21 septembre, Z.ai publie le code de ZCode sur GitHub. J'ai consulté le dépôt : tout arrive dans un seul commit intitulé « feat: open source », qui ajoute 6 973 fichiers et plus d'un million de lignes. L'historique de développement n'y figure pas, on ne peut donc pas voir comment le mécanisme d'envoi a été retiré. Selon ferstar, qui a fouillé ce code, il ne contient plus une ligne de ce mécanisme.
Toujours selon 36Kr, Z.ai a fait intervenir l'Académie chinoise des technologies de l'information et des communications (CAICT) et l'entreprise de sécurité NSFOCUS. Leurs conclusions résumées : l'espace de stockage en cause est vide puis supprimé, et la version 3.14.0 ne contient plus de chemin d'envoi. Les rapports complets ne sont pas encore publiés. Z.ai affirme aussi, d'après The Standard, que les données n'ont jamais servi à entraîner ses modèles.
À mon sens, c'est la bonne réaction, et elle est arrivée vite. Mais ferstar pointe une limite juste : constater qu'un stockage est vide aujourd'hui ne dit rien de ce qui est arrivé aux données avant. Sur ce point, il faut croire Z.ai sur parole.
Le modèle est ouvert, l'application ne l'était pas
Beaucoup de développeurs ont confondu les deux. Les modèles GLM sont publiés en poids ouverts : tu peux les faire tourner chez toi. ZCode, jusqu'au 21 septembre, était une application fermée. L'affaire ne concerne pas les modèles, mais le logiciel qui les entoure et qui a accès à tes fichiers. Un modèle local enveloppé dans une application qui envoie ton dossier vers un serveur n'est plus vraiment local.
→ Voir aussi : Bonsai 2 27B : PrismML annonce 98 % des performances de Qwen3.8, mais pas encore dans Ollama
Ce que ça change pour mon usage de Claude Code
Je n'ai jamais utilisé ZCode. J'utilise Claude Code sur le dépôt de ce blog : je relis ses modifications et je lis ses demandes d'autorisation. Je n'ai en revanche jamais vérifié ses connexions sortantes.
Rien dans cette affaire ne permet de dire que Claude Code fait la même chose. Mais elle montre une limite de ma méthode. D'après l'analyse de Tokenstead, le mécanisme de ZCode ne faisait pas partie des outils de l'agent : il tournait à côté, dans l'application, sans déclencher la moindre demande d'autorisation. Relire ce que l'agent modifie ne dit pas ce que l'application transmet.
Ce que j'en retiens, sans avoir fait moi-même d'analyse réseau :
- Surveiller le dossier de données de l'outil. C'est un dossier de 700 Mo anormal qui a tout déclenché chez ferstar.
- Ne pas se fier au nom d'un réglage. Ceux de ZCode ne faisaient pas ce que leur nom laissait croire.
- Traiter l'historique Git comme sensible. Un secret supprimé du dernier état du projet peut rester dans les anciens commits. Si le dépôt a été partagé, synchronisé ou rendu accessible à un service externe, considère ce secret comme exposé et remplace-le.
- Se poser les deux questions de Tokenstead : que transmet l'outil quand je suis connecté, et qui peut déchiffrer ce qu'il stocke ?
→ Voir aussi : Claude Code Projects : plusieurs agents, quelles limites ?
Mon verdict
Pour moi, ZCode reste à éviter tant que deux choses ne sont pas claires : ce que sont devenues les données envoyées avant le 18 septembre, et ce que fait réellement la version publiée une fois installée. Les rapports complets du CAICT et de NSFOCUS seront le prochain signal à surveiller.
Je ne tire pas de cette affaire une règle contre tous les agents de code fermés. J'en tire une pour moi : un agent qui a accès à mon dépôt mérite que je sache ce qu'il envoie, pas seulement ce qu'il écrit.
FAQ
ZCode a-t-il envoyé les 313 Mo de code ?
Non. Dans le cas documenté par ferstar, l'archive de 313 Mo a échoué 564 fois parce qu'elle dépassait la taille maximale acceptée. Un plus petit dépôt public a en revanche été envoyé avec succès.
Pouvait-on désactiver l'envoi dans les réglages ?
Non, dans la version 3.12.3 analysée par ferstar. Les deux interrupteurs portaient sur l'entraînement et l'indexation côté serveur. Selon les audits résumés par Z.ai, la version 3.14.0 ne contient plus ce mécanisme.
Faire tourner les modèles GLM en local est-il concerné ?
Non. L'affaire porte sur l'application ZCode, pas sur les modèles GLM publiés en poids ouverts.
Les données envoyées ont-elles été effacées ?
Z.ai l'affirme, et les audits résumés indiquent que l'espace de stockage est vide puis supprimé. Mais ces constats datent d'après l'incident et les rapports complets ne sont pas encore publiés.
Transparence : cet article a été préparé avec l'aide de Claude, puis vérifié à partir de l'enquête de ferstar, du dépôt GitHub officiel de ZCode et des déclarations de Z.ai rapportées par la presse. Je n'ai jamais utilisé ZCode.